
Python · numba · scipy · FunctionalScale op GitHub
Overzicht
Klassieke GARCH modelleert één getal, de dagelijkse variantie, als het ding dat de moeite waard is om te schatten. Intraday data geeft je in plaats daarvan een hele curve: volatiliteit heeft een vorm over de handelsdag, niet alleen een niveau. Dit project, ontwikkeld samen met André Lucas en Yicong Lin, behandelt intraday log-return paden als functies \(y_t(u)\) over de handelsdag \(u \in [0,1]\), en breidt de GARCH- recursie uit van een scalaire update naar een operator-update over de hele curve, zodat een schok op elk moment van de dag kan doorwerken in het hele komende volatility surface in plaats van in slechts één getal aan het einde van de dag. Waar het Functional Scale Volatility Estimation project zich richt op het correct schatten van één statische functionele GARCH(1,1)-recursie, breidt dit project hetzelfde Bernstein-basis idee uit naar een echt tijdsvariërend, score-gedreven model, en is het de rekenkundige motor achter de snelle, schaalbare schattingsmethodologie die binnen deze samenwerking wordt gedeeld.
Theoretische Integratie
De theorie hier bouwt op twee papers. Cerovecki, Francq, Hörmann & Zakoïan (2018) leveren de functionele GARCH(1,1)-baseline en de bijbehorende quasi-likelihood schattingstheorie; zie de bijbehorende projectpagina voor de volledige uiteenzetting van dat model in de hier gebruikte notatie. Lin & Lucas (2025, "Functional Location-Scale Models with Robust Observation-Driven Dynamics", Tinbergen Institute Discussion Paper TI 2025-027/III) leveren het score-gedreven update-mechanisme dat het GAS-GARCH-model van dit project implementeert. Hun paper behandelt een veel algemenere setting, gezamenlijke locatie- en scale-dynamiek over een willekeurige functionele dimensie, op schaars geobserveerde data. Deze codebase implementeert het specifieke hoekje van dat raamwerk dat nodig is voor intraday volatiliteit, alleen scale-dynamiek, op een regelmatig intraday grid, geharmoniseerd met de notatie van de vorige pagina.
Zoals eerder werken we in \(H = L^2([0,1])\) met het functionele scale-model \[y_t(u) = \sigma_t(u)\,\eta_t(u), \qquad \sigma_t^2 = \delta + \sum_{i=1}^q \alpha_i(y_{t-i}^2) + \sum_{j=1}^p \beta_j(\sigma_{t-j}^2),\] het functionele GARCH(1,1)-model van de vorige pagina. Door \(\delta\), \(\alpha_i\) en \(\beta_j\) te projecteren op een eindige basis, wordt deze recursie een recursie voor de vector van basiscoëfficiënten \(\gamma_i\) zelf, \[\gamma_{i+1} = \omega + \bar{B}\,\gamma_i + A \int \varphi(s)\,y_i^2(s)\,ds,\] een update die puur wordt aangedreven door de gekwadrateerde returncurve van de vorige dag. De GAS-uitbreiding verandert alleen de aandrijvende term. In plaats van de ruwe gekwadrateerde-return-projectie in te voeren, voert het de score van een fat-tailed log-likelihood in, zodat de grootte van de update van vandaag op \(\gamma_i\) afhangt van hoe verrassend de observatie van vandaag was, niet alleen van de grootte ervan.
Schattingsprocedure
De GAS-recursie voor de B-spline-coëfficiëntenvector \(\gamma_i\) is \[\gamma_{i+1} = \omega + A\,s_i + B\,\gamma_i,\] waarbij \(s_i\) de geschaalde score is van de log-likelihood van het model op dag \(i\), \(\omega\) een constante is, \(B\) de persistentie bepaalt, en \(A\) de gevoeligheid van de update voor nieuwe informatie bepaalt. Returns worden gemodelleerd als een zero-mean Student-\(t\)-proces in plaats van Gaussiaans, zodat een dag met een ongewoon grote of ruizige intraday return automatisch wordt afgewaardeerd bij het berekenen van de score. Dit is dezelfde robuustheidseigenschap die score-gedreven modellen aantrekkelijk maakt in het klassieke, eindig-dimensionale geval, hier overgedragen naar de functionele setting. De covariantie tussen intraday gridpunten wordt zelf gemodelleerd als een Student-\(t\) Ornstein–Uhlenbeck-proces, zodat gridpunten die dicht bij elkaar liggen in intraday-tijd sterker gecorreleerd mogen zijn dan punten die ver uit elkaar liggen. De statische parameters \(\omega,A,B\), samen met de vrijheidsgraden van de Student-\(t\) en de OU-decay-parameter, worden geschat door de resulterende gemiddelde log-likelihood over de steekproef te maximaliseren. Lin & Lucas tonen stationariteit, ergodiciteit, inverteerbaarheid van het filter, sterke consistentie en asymptotische normaliteit van deze schatter aan onder regulariteitsvoorwaarden die analoog zijn aan die gebruikt voor de functionele GARCH QMLE op de vorige pagina.
De GAS-GARCH-implementatie van het funcgarch-pakket is dit scale-only geval. Het vervangt de
Bernstein-basis door een algemene B-spline-basis, flexibeler voor het smoothen van een curve waarvan wordt
verwacht dat deze over de steekproef drift, en gebruikt de Ornstein–Uhlenbeck-kernel voor de Student-
\(t\)-covariantie over het intraday grid. De B-spline-coëfficiëntenvector speelt hierboven de rol van
\(\gamma_i\), en de score-gedreven update laat de gefitte curve een volatiliteitspatroon volgen dat zelf van
vorm verandert over de steekproef, in plaats van één statische operator te fitten op de hele steekproef zoals
het gewone functionele GARCH-model doet.
Codestructuur & Uitleg
Het pakket (funcgarch) splitst in een numerieke kern en een datapipeline die elkaar nooit raken.
De eigen focus van dit project, en waar de uitgewerkte voorbeeldfiguren op deze site uit voortkomen, is
scripts/gas_vol_surface.py, een op zichzelf staande diagonale restrictie van het algemene
score-gedreven model. De algemene, volledige-matrixversie, gas_estimator in gas.py,
laat de persistentie- en gain-termen willekeurige \(M\times M\)-matrices \(B,A\) zijn; de hier gebruikte
diagonale restrictie leert in plaats daarvan één persistentiecoëfficiënt en één gain-coëfficiënt per
basisfunctie, \(b,a \in \mathbb{R}^M\) elementsgewijs toegepast, een veel kleiner aantal parameters dat
makkelijker te identificeren is uit één gesimuleerd of empirisch panel.
basis.py—cubic_bspline_basisbouwt de B-spline-basismatrix \(\Phi\), enou_kernelbouwt de Ornstein–Uhlenbeck-covariantie die gebruikt wordt voor de Student-\(t\)-likelihood hieronder.garch.py— de Bernstein-basis functionele GARCH(1,1), behandeld op de vorige pagina; hier alleen herbruikt als de niet-score-gedreven benchmark in de vergelijkingsfiguur.gas.py—gas_estimator, de algemene volledige-matrix GAS-recursie met een Student-\(t\)-score.scripts/gas_vol_surface.py—simulate_vol_surface,_gas_filter,fit_gasengoodness_of_fit, het diagonale GAS-voorbeeld dat gebruikt is voor de figuren van dit project.scripts/taq_cleaner.py— herstructureert ruwe WRDS TAQ CSV-exports naar de(n_grid, n_days)-matrix die het kernpakket verwacht.
Het uitgewerkte voorbeeld doorloopt vier stappen: simuleer een surface met een bekende vorm, draai het score-gedreven filter erover, fit het model om de parameters terug te vinden, en controleer dan de fit. De uitleg hieronder volgt die volgorde.
Stap 1. Simuleer een surface met een bekende vorm
simulate_vol_surface bouwt de testomgeving. Het genereert een bekend, tijdsvariërend intraday
volatility surface met een U-vormig profiel waarvan het dal sinusoïdaal drift over de steekproef, en trekt
daarna Gaussiaanse returns geschaald met de wortel ervan. Omdat de echte surface exact bekend is, kan wat de
schatter in stap 3 terugvindt direct ertegen worden getoetst.
def simulate_vol_surface(n: int, T: int, seed: int = 0) -> tuple[np.ndarray, np.ndarray]:
    rng = np.random.default_rng(seed)
    grid_i = np.arange(n)
    sigma2 = np.zeros((n, T))
    for t in range(T):
        centre = n / 2 + (n / 4) * np.sin(t * 3 * np.pi / T)
        sigma2[:, t] = (
            4
            + 10 * (grid_i - centre) ** 2 / (0.75 * n) ** 2
            + 2 * np.sin(t * 2 * np.pi / T)
        )
    mY = np.sqrt(sigma2) * rng.standard_normal((n, T))
    return mY, sigma2
Stap 2. Draai het score-gedreven filter
_gas_filter is waar de score-gedreven update daadwerkelijk gebeurt. Op elke dag berekent het de
huidige log-volatiliteitscurve uit de B-spline-coëfficiënten, standaardiseert de return van de vorige dag
ertegen en tegen de OU-covariantiekernel om de Student-\(t\) kwadratische vorm te krijgen, projecteert de
resulterende errorterm terug op de B-spline-basis om de score te krijgen, en werkt dan de coëfficiëntenvector
bij via de diagonale GAS-recursie \(b_t = \omega + b*b_{t-1} + a*s_{t-1}\), waarbij \(*\) elementsgewijze
vermenigvuldiging is.
for t in range(1, T):
    sigma_now = basis_mat.T @ vb_now       # (n, 1) — log sigma2_t at each grid point
    log_sigma2[:, t] = sigma_now[:, 0]

    S = np.exp(sigma_now / 2)              # (n, 1) — sigma_t (conditional std dev)
    R = np.eye(n) / S                      # (n, n) — diag(1/sigma_t)
    Y = vy_now                             # (n, 1) — returns on day t-1

    A1 = float(np.sum(1 + Y.T @ R @ cov_inv @ R @ Y / nu))
    A2 = (Y / S).T * basis_mat
    A3 = A2 @ (cov_inv @ (R @ Y))
    score = (
        -0.5 * basis_mat.sum(axis=1, keepdims=True)
        + (nu_scale / A1) * A3
    )

    if t > 5:
        log_lik += (
            -0.5 * float(np.sum(sigma_now))
            - (n + nu) / 2 * np.log(A1)
        )

    vb_now = omega + vb * vb_now + va * score
    vy_now = mY[:, t].reshape(n, 1)
Twee dingen zijn goed om te weten. cov_inv is de inverse van de \(N\times N\)
Ornstein–Uhlenbeck-kernelmatrix. Die wordt één keer per optimizer-stap berekend, niet één keer per dag,
omdat hij niet afhangt van \(t\). Zonder dit uit de loop te tillen zou één SLSQP-call een
\(N\times N\)-matrix moeten inverteren op elke dag, voor elke functie-evaluatie. A1 is de
Student-\(t\) kwadratische vorm die in de noemer van de score-gain staat, zodat een dag met een groot
gestandaardiseerd residu automatisch een kleinere score-update oplevert. Dat is het
outlier-robuustheidsmechanisme dat de theorie voorspelt.
Stap 3. Fit het model
fit_gas verpakt het filter in een scipy.optimize.minimize-call. De
parametervector is opgebouwd als [nu, delta, omega (M) | b (M) | a (M)], lengte \(2+3M\), met
box-bounds die \(\nu>1\) houden (eindig Student-\(t\)-gemiddelde), de OU-lengteschaal in \((0,1]\), en de
diagonale persistentie- en gain-termen binnen respectievelijk \((-1,1)\) en \((-0.5,0.5)\), standaard
stabiliteitsranges voor een score-gedreven recursie.
def fit_gas(
    mY: np.ndarray,
    dK: int = DK,
    n_int_knots: int = N_INT_KNOTS,
    maxiter: int = MAXITER,
) -> tuple[np.ndarray, np.ndarray, np.ndarray]:
    n = mY.shape[0]
    M = dK + 1
    vtau      = np.linspace(0, 1, n)
    basis_mat = cubic_bspline_basis(vtau, order=dK - 2, n_interior_knots=n_int_knots)

    vb0     = np.ones((M, 1))
    vtheta0 = np.concatenate((
        [2.1, 0.5], np.ones(M), 0.5 * np.ones(M), 0.05 * np.ones(M)
    ))
    LB = np.concatenate(([1.05, 1e-5], -5 * np.ones(M), -0.99 * np.ones(M), -0.5 * np.ones(M)))
    UB = np.concatenate(([50,   1.0],  15 * np.ones(M),  0.99 * np.ones(M),  0.5 * np.ones(M)))

    opt = minimize(
        lambda vtheta: _gas_filter(mY, vb0, dK, basis_mat, vtheta)[0],
        vtheta0, bounds=list(zip(LB, UB)),
        method='SLSQP', options={'maxiter': maxiter, 'ftol': 1e-9},
    )
    _, log_sigma2_hat = _gas_filter(mY, vb0, dK, basis_mat, opt.x)
    return opt.x, np.exp(log_sigma2_hat / 2), basis_mat
Stappen 1 tot 3 end-to-end draaien is drie calls: simuleer een surface, fit het diagonale GAS-model erop, en score dan de fit.
mY, sigma2_true = simulate_vol_surface(n=25, T=500, seed=42)
vtheta_hat, sigma_hat, basis_mat = fit_gas(mY)

nu_hat, delta_hat = vtheta_hat[0], vtheta_hat[1]
metrics = goodness_of_fit(mY, sigma_hat, sigma2_true, nu_hat)
Stap 4. Controleer de fit
goodness_of_fit is de directe empirische check van de theorie hierboven. Onder correcte
specificatie zouden de gestandaardiseerde residuen \(z_t(u) = y_t(u)/\hat\sigma_t(u)\) moeten lijken op
trekkingen uit een Student-\(t(\hat\nu)\)-verdeling. Naast RMSE, MAE, Pearson-correlatie en \(R^2\) tussen de
gefitte en echte volatiliteit, toetst het het tweede moment van \(z\) tegen de theoretische waarde
\(\hat\nu/(\hat\nu-2)\) en draait het een Kolmogorov–Smirnov-toets van \(z\) tegen \(t(\hat\nu)\).
z    = (mY[:, warmup:] / sigma_hat[:, warmup:]).ravel()
rmse = np.sqrt(np.mean((sigma_hat[:, warmup:] - np.sqrt(sigma2_true[:, warmup:])) ** 2))
r2   = 1 - np.sum((sigma_hat - np.sqrt(sigma2_true)) ** 2) \
         / np.sum((np.sqrt(sigma2_true) - np.sqrt(sigma2_true).mean()) ** 2)

resid_var = np.mean(z ** 2)                        # should be close to nu_hat / (nu_hat - 2)
ks_stat, ks_pval = stats.kstest(z, stats.t(df=nu_hat).cdf)
Vectorisatie vermijdt Python-level loops over het intraday grid in beide modellen. De functionele GARCH-recursie in garch.py evalueert zijn Bernstein-kernelmatrices één keer per optimizer-stap, en de basis-opbouwfuncties zijn JIT-gecompileerd met Numba, behandeld op de vorige pagina. Het GAS-filter hierboven blijft in plain NumPy, omdat de kosten per dag gedomineerd worden door matrixproducten tegen de \(N\times N\) covariantie-inverse, werk dat BLAS al vectoriseert, en het moet een gewone Python-functie blijven die scipy.optimize.minimize direct kan aanroepen.
Resultaten & Interpretatie
Drie figuren hieronder gebruiken dezelfde gesimuleerde dataset uit stappen 1 tot 3: een 25×500 intraday grid met een bekend, tijdsvariërend U-vormig volatility surface. Elke figuur isoleert één vergelijking, dus begin met de gewone functionele GARCH-fit op zichzelf, voordat de GAS-schatting zich erbij voegt.
Eerst de Bernstein-basis functionele GARCH(1,1)-fit van de vorige pagina, met \(M=3\) basisfuncties, naast de echte surface die hij probeert terug te vinden.
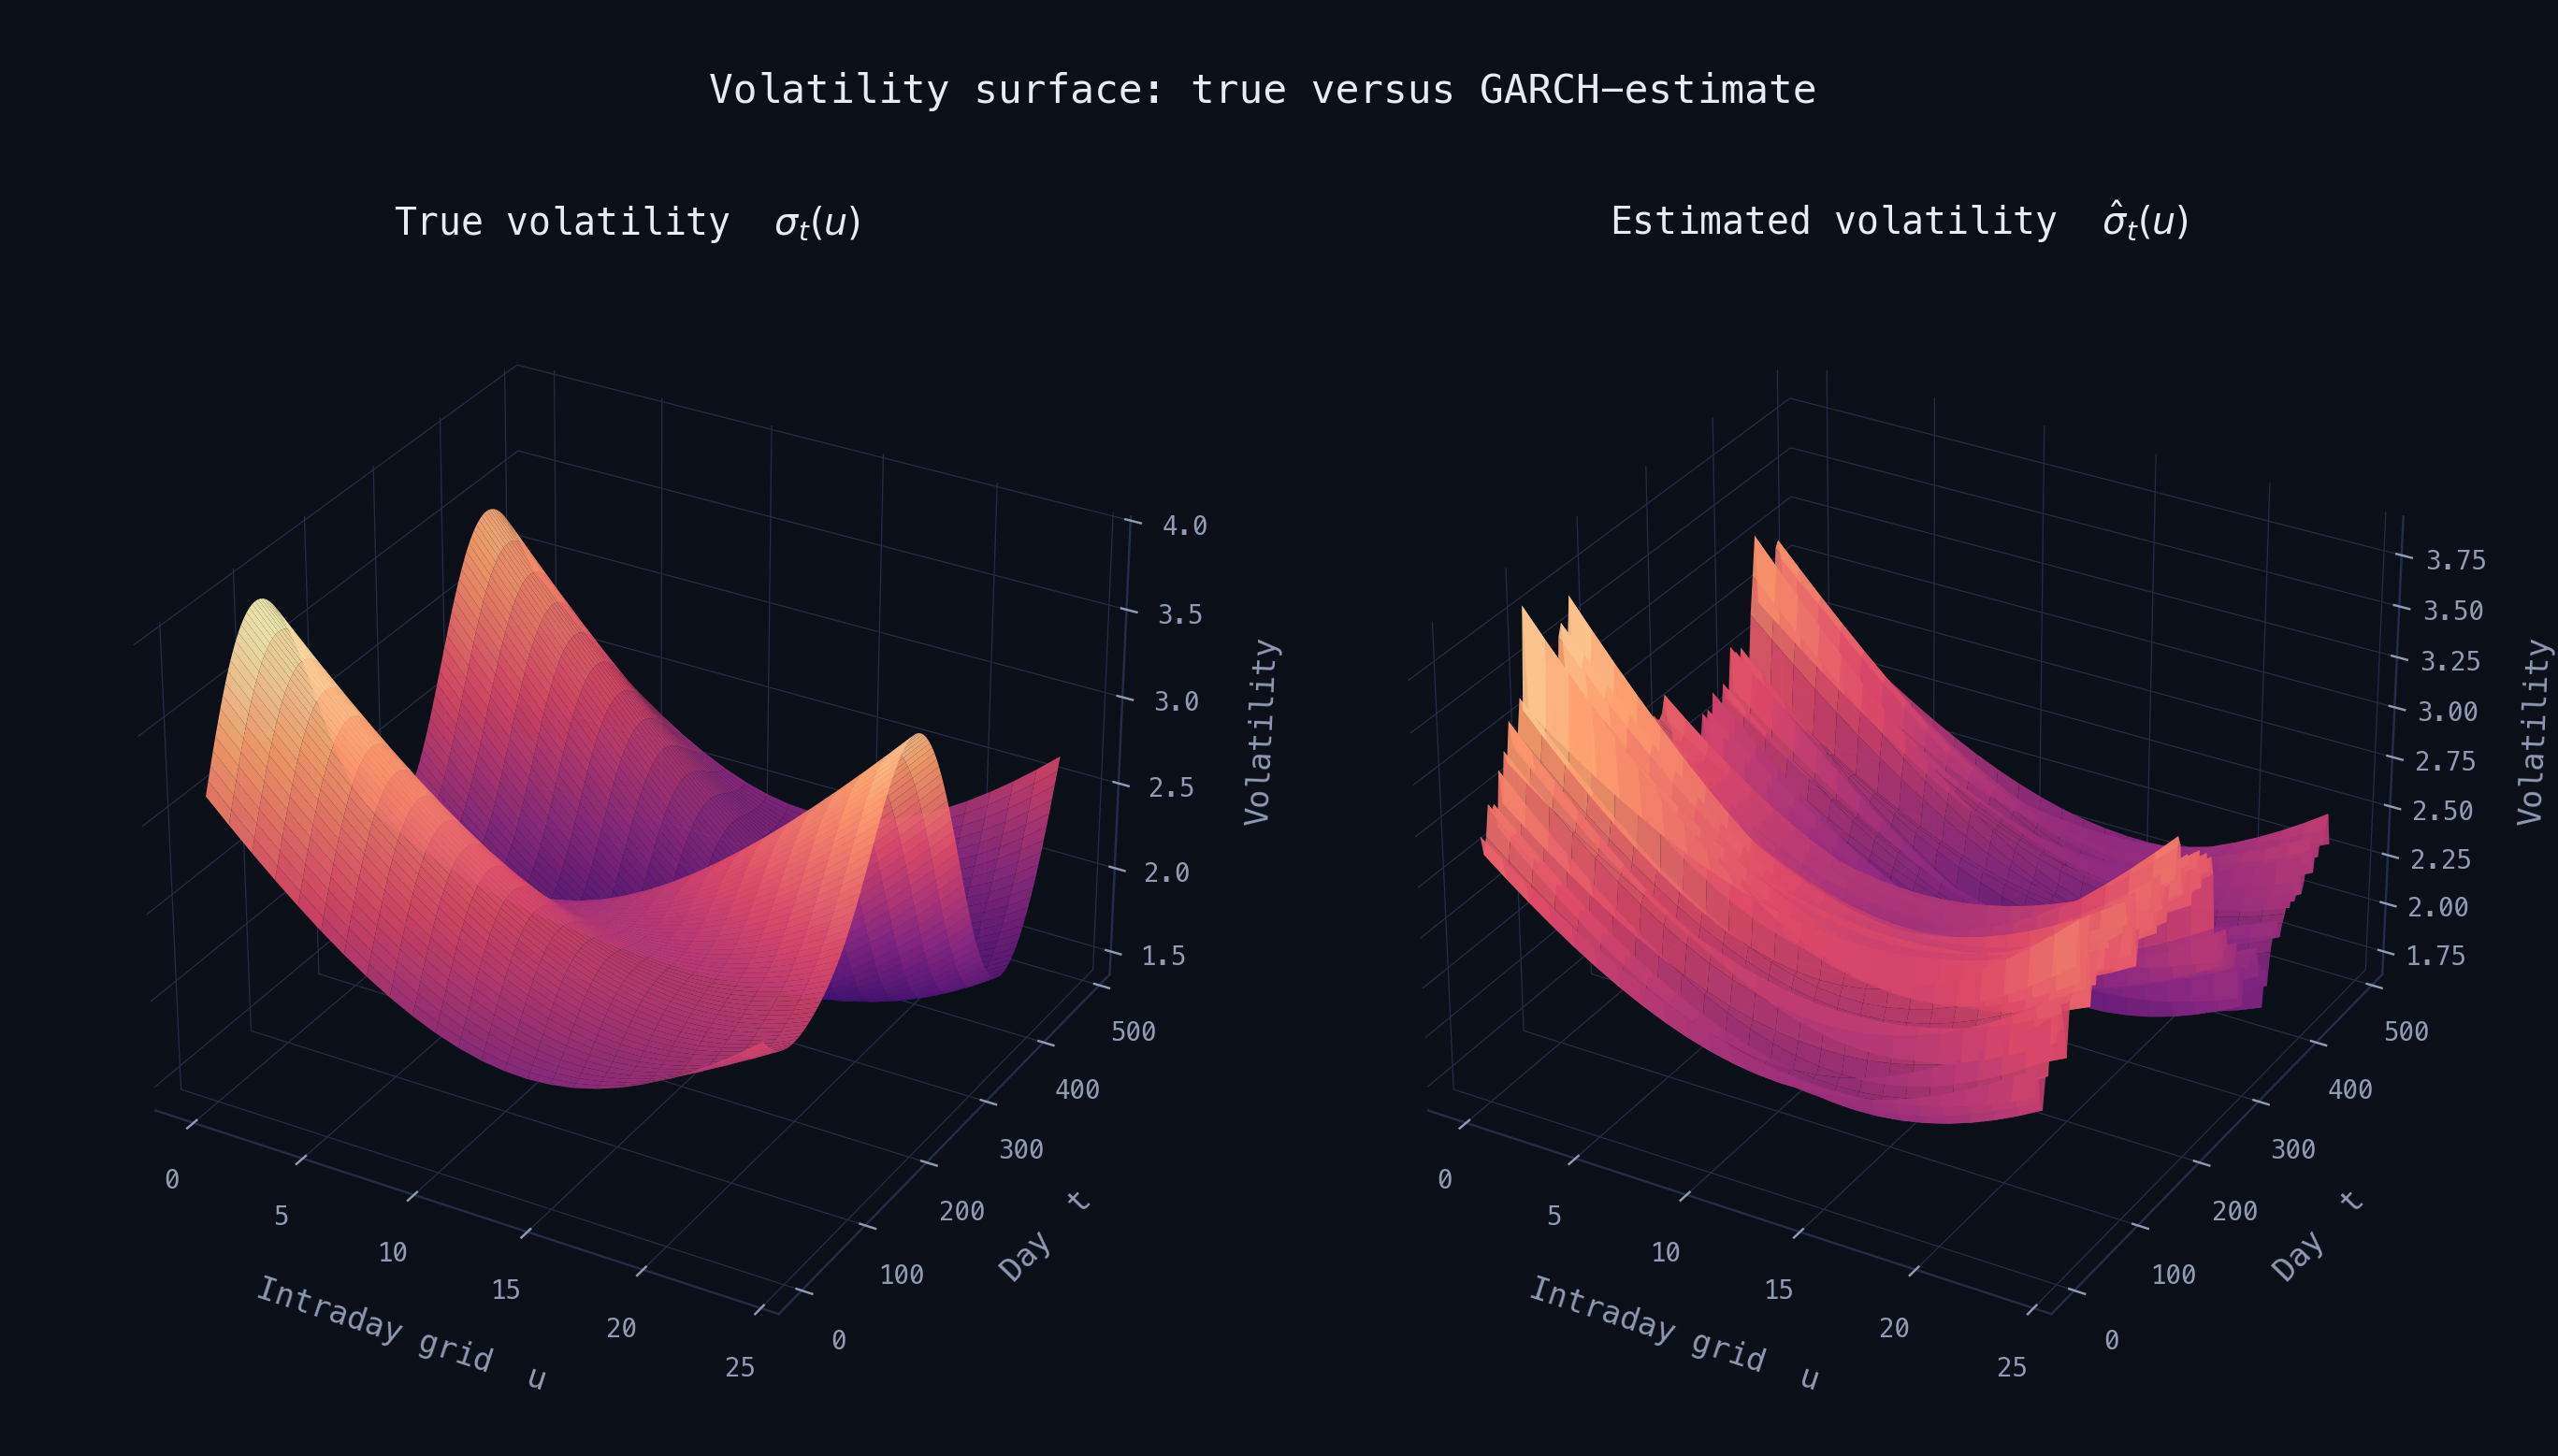
Gesimuleerd 25-punts intraday grid over 500 handelsdagen. Geschatte surface via funcgarch.garch.fit + garch_filter.
De hoofdvorm wordt correct opgepikt. De dag-op-dag ruwheid die overblijft komt van ruis door de beperkte steekproef en de beperkte flexibiliteit van een basis met maar drie functies, niet van een fout in de schatter.
Vervolgens dezelfde echte surface naast de diagonale GAS-GARCH-fit uit stap 3 hierboven, met dezelfde gesimuleerde data.
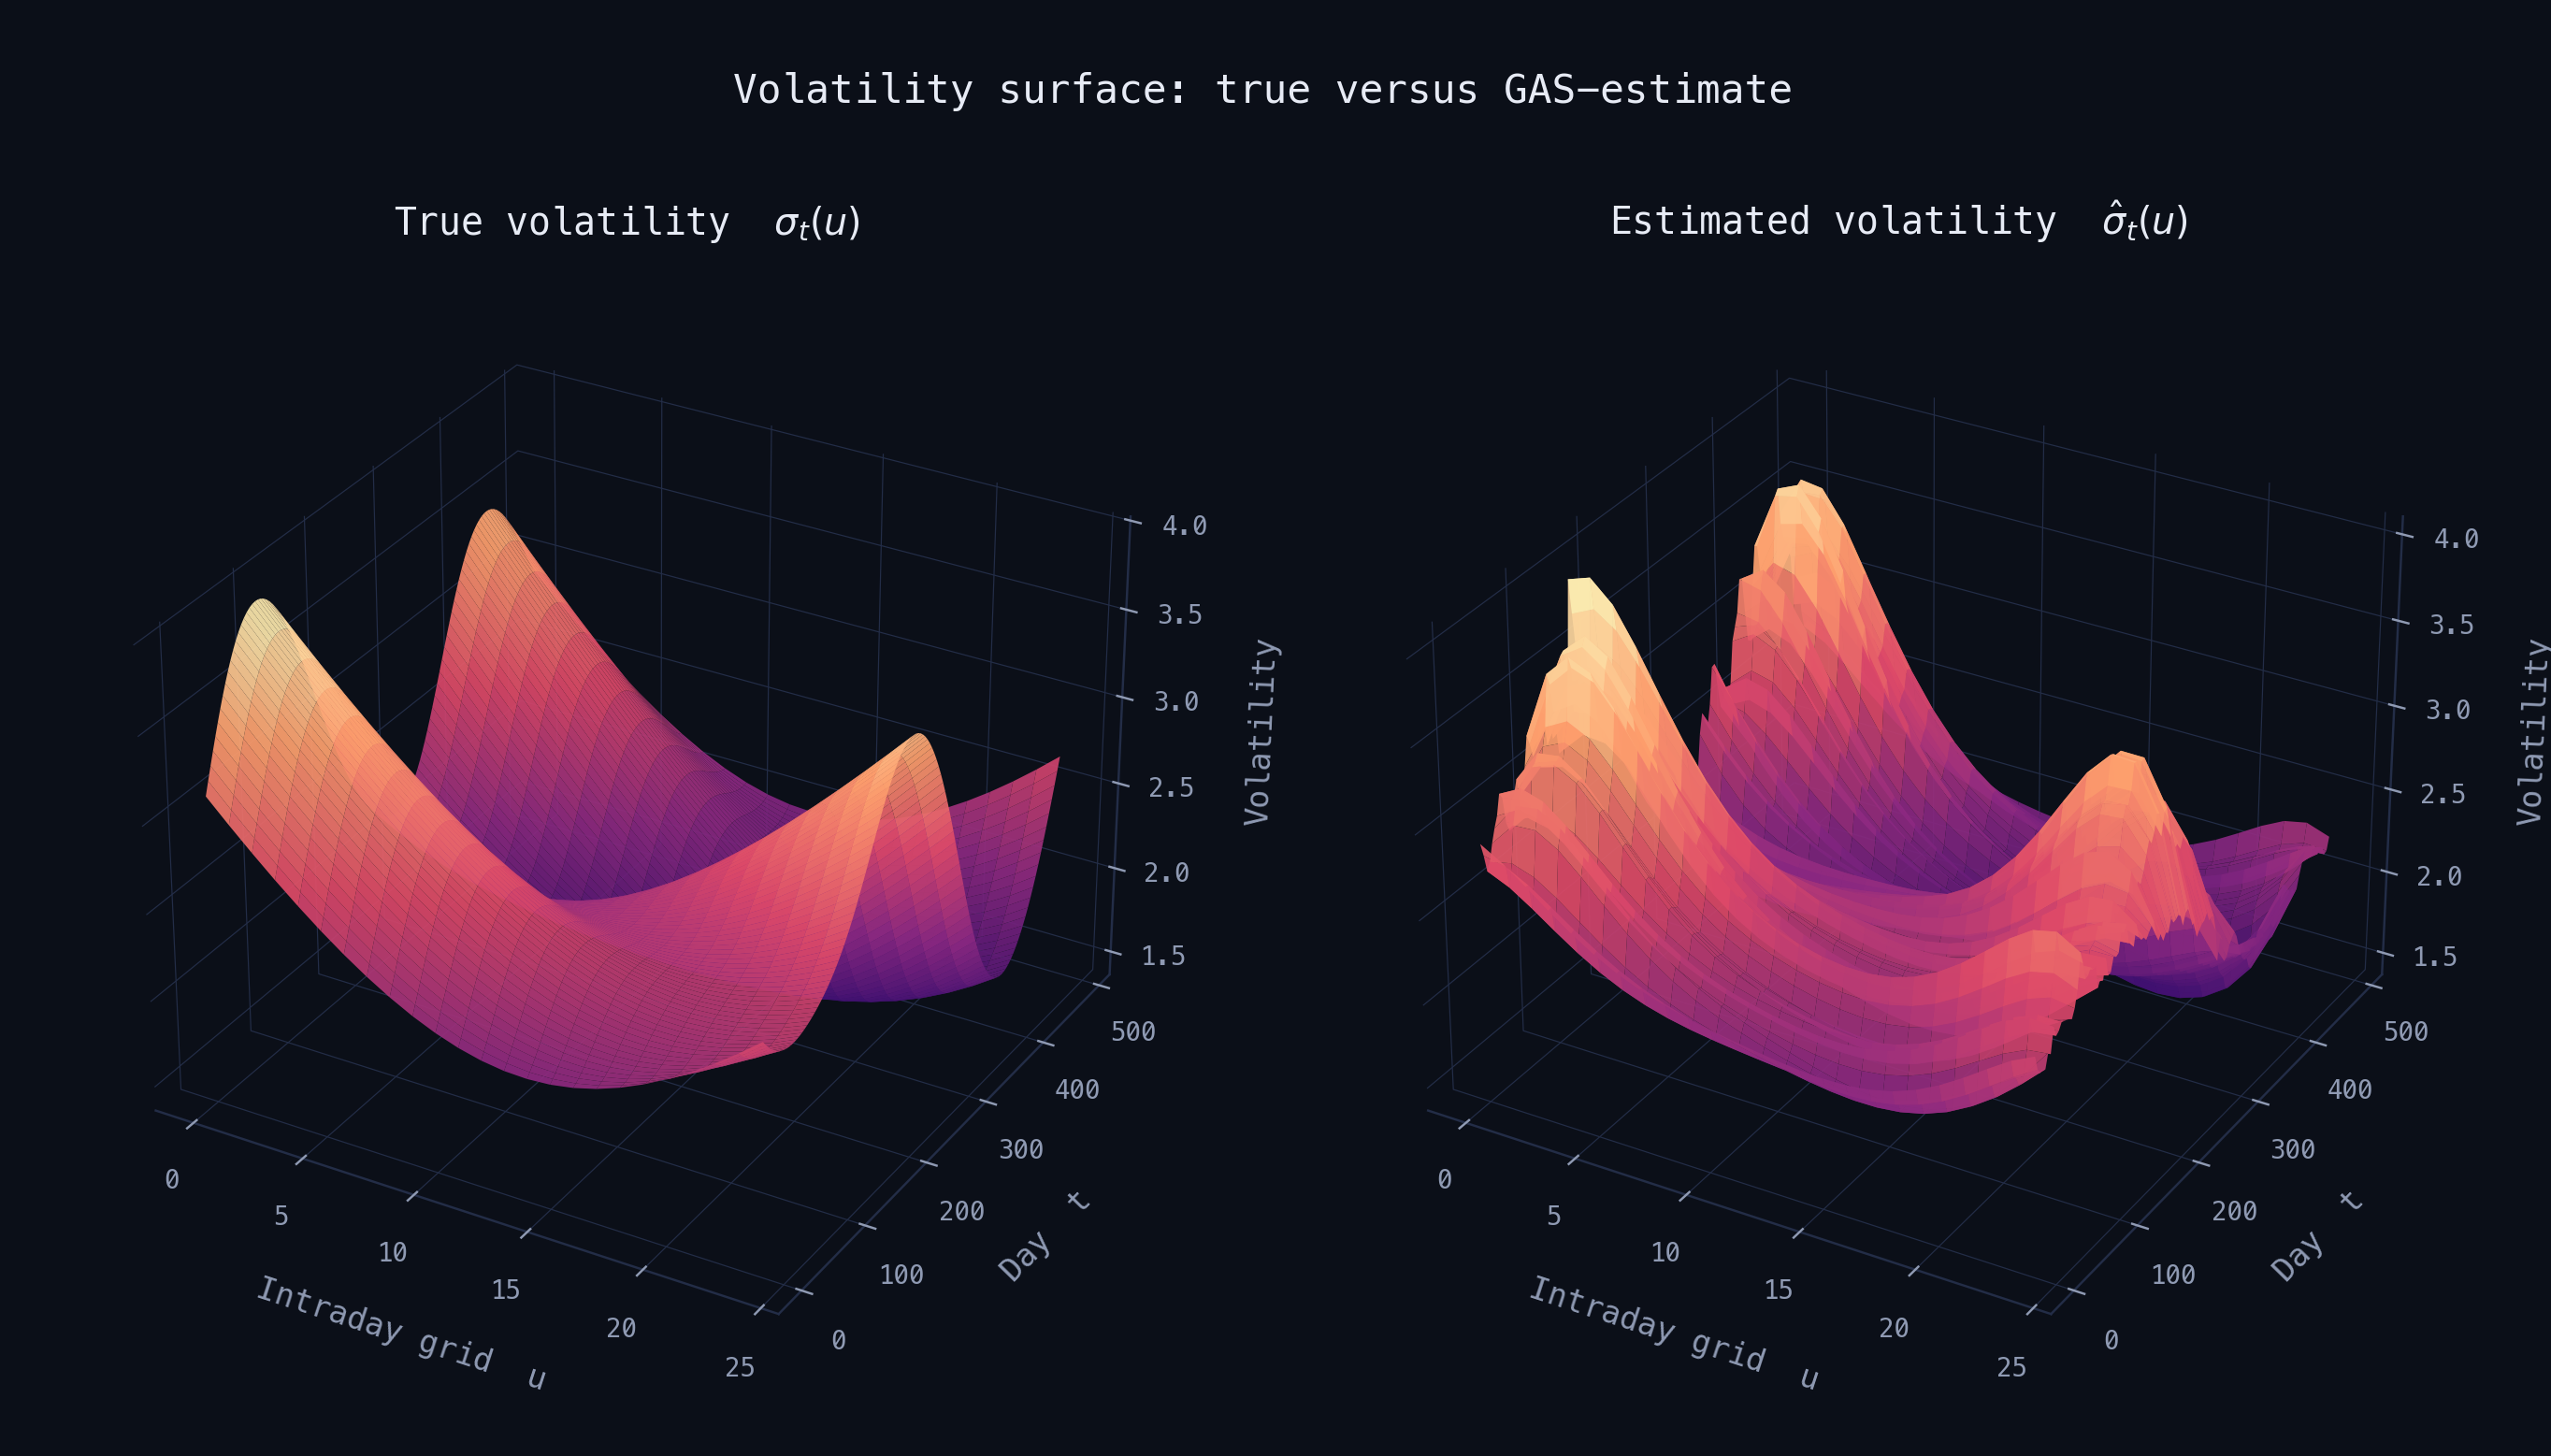
Het GAS-GARCH volatility surface naast de echte surface, ter beoordeling van het herstel van de onderliggende dynamiek.
De goodness_of_fit-checks uit stap 4 bevestigen dit direct: de gestandaardiseerde residuen
komen dicht bij hun theoretische Student-\(t\)-momenten terecht, en de Kolmogorov–Smirnov-toets
verwerpt niet. Omdat de score-gedreven update zijn B-spline-coëfficiënten elke dag aanpast, in plaats van één
statische operator te fitten op de hele steekproef, volgt deze fit de echte surface strakker dan de gewone
GARCH-fit hierboven.
Tot slot de twee gefitte surfaces direct naast elkaar, in plaats van elk apart tegen de waarheid. Dit maakt het smoothing-effect van de score-gedreven aanpassing makkelijker te zien.
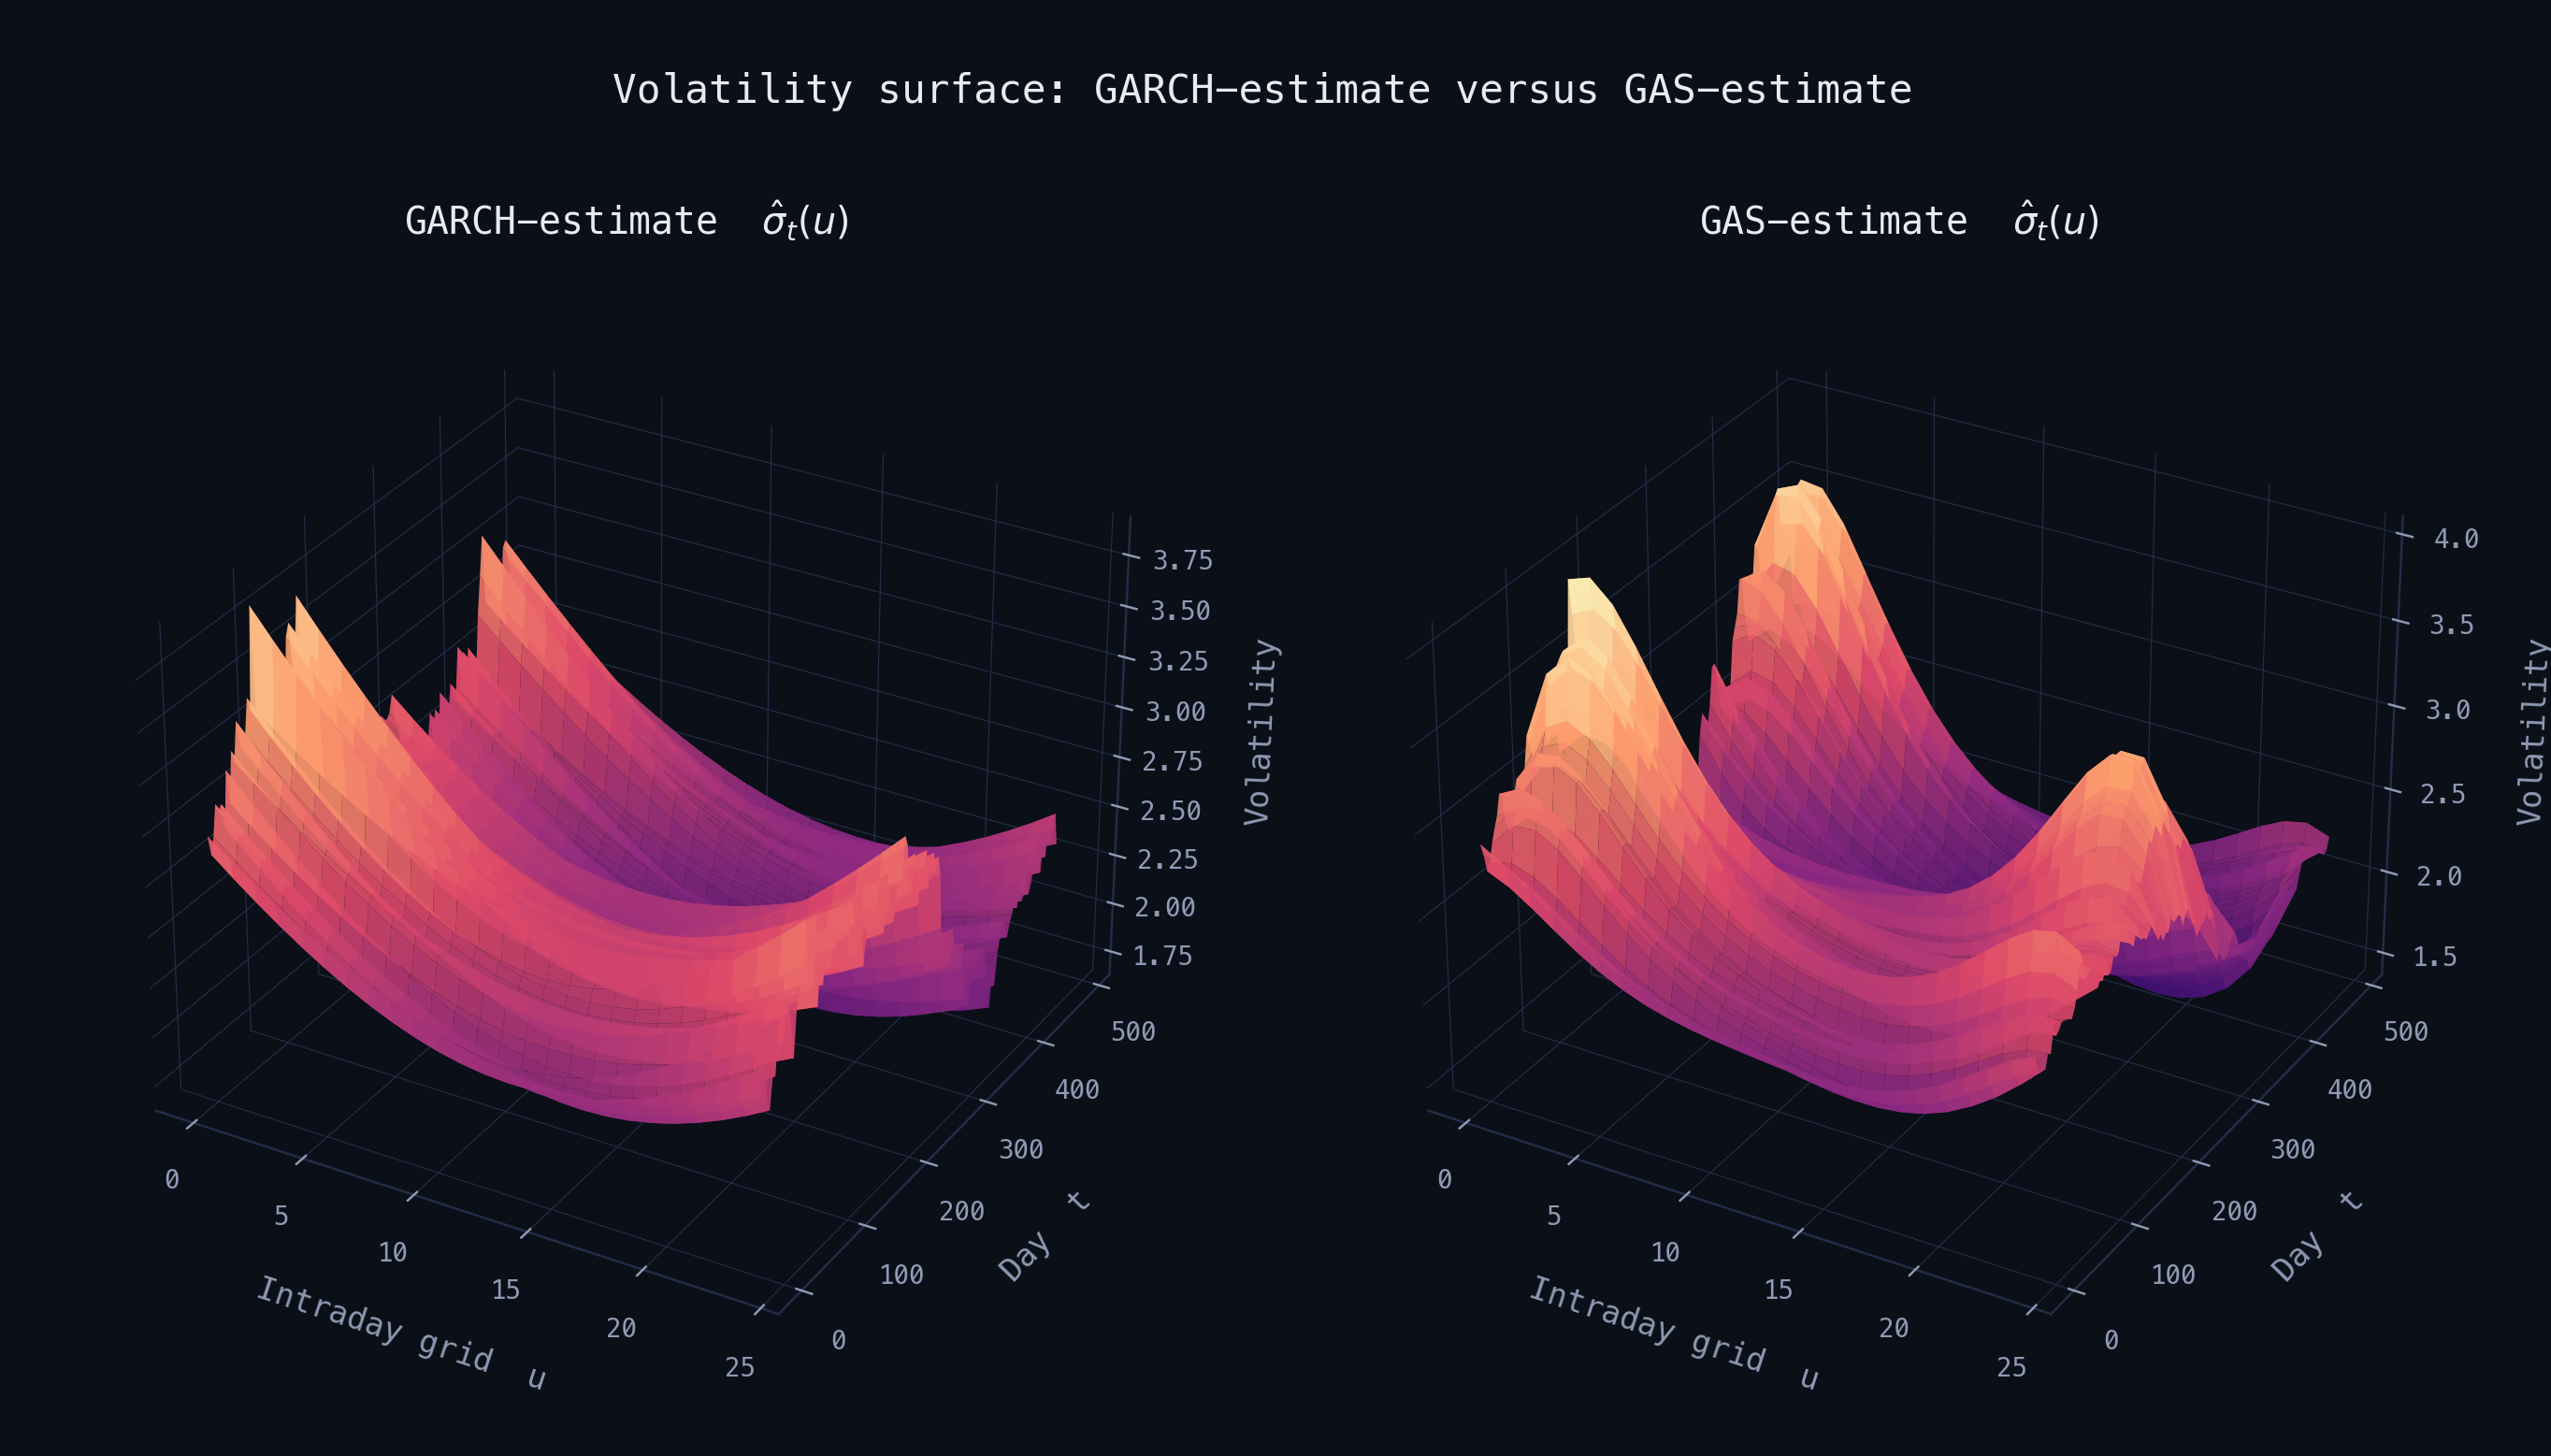
Functional GARCH versus GAS-GARCH, met de toegenomen flexibiliteit van de score-gedreven specificatie.
Dit is precies wat de theorie voorspelt. Een statische functionele GARCH-operator, hoe goed ook gefit, is één punt in de operatorruimte. Hij kan een surface waarvan de vorm zelf verandert niet volgen. Een score-gedreven update past, door constructie, zijn basiscoëfficiënten elke dag aan in de richting die de fit op de laatste observatie lokaal verbetert, en het outlier-afwaarderingsmechanisme dat in de Student-\(t\)-score is ingebouwd, voorkomt dat die aanpassing overreageert op één enkele ruizige dag. In de eigen empirische toepassingen van Lin & Lucas, intraday volatiliteit van het Pfizer-aandeel tijdens de COVID-19-pandemie en PM2.5-concentraties van schaarse, ruizige citizen-science sensoren door heel Europa, presteert hetzelfde robuuste score-gedreven mechanisme beter dan de niet-robuuste functionele GARCH-benchmark, specifiek tijdens periodes van markt- of meetstress. Dat is de empirische handtekening van het theoretische robuustheidsresultaat: outlying observaties worden afgewaardeerd in de parameterupdate, in plaats van klakkeloos opgenomen in de gefitte surface.
Dataflow
Intraday trades worden opgehaald uit WRDS TAQ, schoongemaakt en herstructureerd naar de returnmatrix
mY, en daarna doorgegeven aan de schatters hierboven. De funcgarch-kern blijft
volledig los van deze pipeline. Hij importeert nooit iets WRDS- of TAQ-specifieks, en verbruikt alleen ooit
een gewone numpy-matrix.
wrds/*.sas                    scripts/taq_cleaner.py           funcgarch/* + scripts/gas_vol_surface.py
┌─────────────────┐           ┌────────────────────┐           ┌──────────────────────┐
│ WRDS TAQ pull   │  raw CSV  │ DataCleaner.clean()│  mY (N,T) │ fit() / garch_filter │
│ (data_fetcher,  │ ────────► │  - align to grid   │ ────────► │ fit_gas / _gas_filter│
│  taq_cleaner,   │           │  - compute returns │           │                      │
│  nbbo/dynamic_  │           │  - reshape to      │           │  -> vtheta_hat,      │
│  taq_minute,    │           │    (N, T) matrix   │           │     sigma_hat        │
│  export)        │           │                    │           │                      │
└─────────────────┘           └────────────────────┘           └──────────────────────┘
Vereist Python ≥ 3.9. Pytest smoke tests dekken Bernstein partition-of-unity, positive-definiteness van de OU-kernel, en shape/finiteness van de GARCH-filteroutput.