
Python · SAS · Bash
Context & aanleiding
Dit project is de schattings- en implementatiekant van een lopende samenwerking met André Lucas en Yicong Lin over observation-driven dynamiek voor functionele location-scale modellen. Het doel van de codebase is bewust smal: bouw een snelle, numeriek stabiele schatter voor één functionele GARCH(1,1)-recursie, goedkoop genoeg om duizenden keren opnieuw te draaien binnen een Monte Carlo-studie of een rolling forecast-oefening. Het is de directe voorloper van het project Functional Volatility Surface Modelling, dat dezelfde Bernstein-basis-machinerie hergebruikt maar de statische GARCH-recursie vervangt door een score-driven update over een B-spline-basis.
Computationele schaalbaarheid is hier een echt knelpunt, geen voetnoot. Een functioneel GARCH-model schat niet een handvol scalars zoals een klassieke GARCH(1,1) dat doet. Het schat operatoren die krommen op krommen afbeelden, objecten die in principe oneindig-dimensionaal zijn. Elke evaluatie van de doelfunctie bouwt deze operatoren opnieuw op vanuit de huidige parameterschatting, materialiseert ze als dichte kernel- matrices op het intraday-raster, en loopt de variantierecursie door de volledige steekproef van handelsdagen. Als het raster \(N\) intraday-punten heeft, is elke recursiestap een \(N\times N\) matrix-vectorproduct, en de optimizer heeft duizenden functie-evaluaties nodig om te convergeren, dus die kosten worden duizenden keren betaald. De kosten per evaluatie laag houden is wat de hele aanpak werkbaar maakt, vandaar de JIT-gecompileerde kernel- builders, de gevectoriseerde recursie, en de scheiding tussen wat over tijdstappen heen gecachet kan worden en wat elke dag echt verandert.
Theoretisch kader
De theoretische basis voor dit project is het functionele GARCH quasi-maximum-likelihood-kader van Cerovecki, Francq, Hörmann & Zakoïan (2018, MPRA Paper No. 83990). We werken in de Hilbert- ruimte \(H = L^2([0,1])\) van kwadratisch-integreerbare functies op het eenheidsinterval, en schrijven \(\mathcal{K}^+(H)\) voor de niet-negatieve kernel-operatoren op \(H\). Een operator \(\alpha \in \mathcal{K}^+(H)\) werkt op een kromme \(x \in H\) via \(\alpha(x)(u) = \int K_{\alpha}(u,v)x(v)\,dv\) voor een niet-negatieve kernel \(K_{\alpha}\).
Schrijf \(y_t(u)\) voor het log-rendement op intraday-tijdstip \(u \in [0,1]\) op handelsdag \(t\). Elke dag levert een hele kromme op in plaats van één getal, en dat is precies wat het schattingsprobleem functioneel maakt in plaats van scalair. Een functioneel GARCH\((p,q)\)-proces is een stationaire oplossing van \[y_t = \sigma_t \eta_t, \qquad \sigma_t^2 = \delta + \sum_{i=1}^q \alpha_i(y_{t-i}^2) + \sum_{j=1}^p \beta_j(\sigma_{t-j}^2),\] waarbij \(\eta_t\) een i.i.d.-reeks innovatiekrommen is, \(\delta\) een strikt positieve intercept- kromme is, en \(\alpha_i,\beta_j \in \mathcal K^+(H)\) niet-negatieve kernel-operatoren zijn. Het is het functionele analogon van een klassieke GARCH-recursie. De intercept, de ARCH- en GARCH- coëfficiënten, en de conditionele variantie zelf zijn nu krommen of operatoren die op krommen werken, geen getallen.
De vorm van de kernel \(K_{\alpha}\) bepaalt hoe schokken zich over intraday-tijd verspreiden. Een constante kernel maakt dat de volatiliteit van vandaag alleen afhangt van de geïntegreerde volatiliteit van gisteren, uniform over de dag. Een kernel die gepiekt is rond de diagonaal maakt juist dat de volatiliteit van vandaag op tijdstip \(u\) vooral afhangt van de volatiliteit van gisteren rond datzelfde tijdstip van de dag, een veel realistischer patroon van intraday- persistentie. Deze vorm terugvinden, samen met de vorm van \(\delta\), op basis van data is de taak van de schattingsprocedure hieronder. Het bestaan van een stationaire oplossing wordt bepaald door een top-Lyapunov-exponent- voorwaarde analoog aan het scalaire GARCH-geval, strikt milder dan de eerdere voldoende voorwaarden van Aue, Horváth & Pellatt (2016).
De operatoren \(\alpha_i,\beta_j\) leven in een oneindig-dimensionale ruimte, en kunnen dus niet direct geschat worden uit een eindige steekproef van dagen, en elke operator moet de variantiekromme positief houden. We lossen beide problemen op door elke operator te projecteren op een kleine set van \(M\) lineair onafhankelijke, niet-negatieve basisfuncties \(\varphi_1,\dots,\varphi_M \in H\), \[\delta = \sum_{k=1}^M d_k \varphi_k, \qquad \alpha_i = \sum_{k,\ell=1}^M a^{(i)}_{k,\ell}\,\varphi_k \otimes \varphi_\ell, \qquad \beta_j = \sum_{k,\ell=1}^M b^{(j)}_{k,\ell}\,\varphi_k \otimes \varphi_\ell.\] Dit maakt van een oneindig-dimensionaal schattingsprobleem een eindig probleem, over de coëfficiëntenvector \(\theta = \mathrm{vec}(d, A_1,\dots,A_q,B_1,\dots,B_p)\). De basis die doorheen deze codebase gebruikt wordt, is de Bernstein-polynoombasis, \(M\) polynomen op \([0,1]\), elk overal niet-negatief op dat interval. Als de coëfficiënten allemaal niet-negatief zijn, zijn de resulterende intercept- en kernel-operatoren automatisch niet-negatief, dus de gefitte variantiekromme is automatisch niet-negatief. Positiviteit wordt afgedwongen door constructie in plaats van door de optimizer te beperken. Bernstein-polynomen zijn een speciaal geval van B-splines, en zijn ook de basis die Cerovecki et al. in hun eigen empirische studie gebruiken. Het Functional Volatility Surface Modelling-project wisselt dit voor zijn score-driven uitbreiding in voor een algemene B-spline-basis.
Schatting & methodologie
Een likelihood kan niet direct opgeschreven worden voor een proces met waarden in \(H\), dus de gebruikelijke quasi-maximum-likelihood-machinerie gaat niet zomaar over. Cerovecki et al. definiëren in plaats daarvan een schatter geïnspireerd door de klassieke GARCH-QMLE. Deze projecteert het gekwadrateerde proces op dezelfde basisfuncties die gebruikt worden om de operatoren te parametriseren, en beoordeelt de fit met een Gaussian-QMLE-achtig criterium, geëvalueerd op die projecties, \[\widehat\theta_n = \operatorname*{argmin}_{\theta \in \Theta} \frac1n\sum_{t=1}^n \sum_{m=1}^M \left\{ \frac{\langle y_t^2, \varphi_m\rangle}{\langle\tilde\sigma_t^2,\varphi_m\rangle} + \log\langle\tilde\sigma_t^2,\varphi_m\rangle \right\},\] waarbij de gefitte volatiliteitskromme \(\tilde\sigma_t^2\) gegenereerd wordt door dezelfde recursie als het model, gestart vanuit een vaste startkromme. Omdat de basisfuncties strikt positief zijn en de operatoren niet-negatief, is elke term in het criterium welgedefinieerd, en is minimaliseren ervan een goed gesteld eindig-dimensionaal probleem. Onder standaard identificeerbaarheids-, moment- en invertibiliteitsvoorwaarden is de schatter sterk consistent en asymptotisch normaal met de gebruikelijke parametrische snelheid. Hetzelfde argument levert, als bijproduct, consistentie en asymptotische normaliteit op voor semi-strong multivariate CCC-GARCH- modellen, omdat de eindig-dimensionale projectie precies een multivariate CCC-GARCH-representatie is van het functionele model.
In de praktijk wordt de recursie gediscretiseerd op een uniform intraday-raster van \(N\) punten. Inproducten worden Riemann-sommen, en een toepassing van een kernel-operator wordt een matrix-vectorproduct met de \(N\times N\)- matrix die ontstaat door de kernel op het raster te evalueren. Optimalisatie over \(\theta\) gebeurt numeriek met SLSQP, met eenvoudige niet-negativiteits-boxconstraints op de Bernstein-coëfficiënten in plaats van de abstracte niet-negativiteitseis op de operatoren.
Codestructuur & walkthrough
Het hele project zit in één bestand, funcgarch/garch.py: het Bernstein-basis functionele
GARCH(1,1)-model, zijn filter, en zijn schatter. Vijf onderdelen doen het werk, en ze lopen in deze volgorde elke
keer dat je het model fit: de basisfuncties opbouwen, de kernel-operatoren opbouwen uit een parameterschatting, de
dagloop draaien, de fit van elke dag scoren, en dan het geheel doorgeven aan een optimizer. De walkthrough hieronder volgt
die volgorde. Bij elke stap is de vraag steeds dezelfde: is dit onderdeel het JIT-compileren met Numba waard, of is
het beter als gewone NumPy die BLAS aanroept?
Stap 1. De Bernstein-basis
bernstein_basis berekent \(\varphi_k^M(u) = \binom{M-1}{k-1}u^{k-1}(1-u)^{M-k}\), één Bernstein-
polynoom uit de theorie hierboven. Hij wordt \(O(M)\) keer per rasterpunt aangeroepen, bij elke evaluatie van
de doelfunctie. Dat is een scalair-zware Python-loop zonder matrixalgebra om aan BLAS over te dragen, precies
de vorm van code waarvoor Numba gebouwd is. Hij is gedecoreerd met @jit(nopython=True), Numba's
nopython-modus: compileer naar machinecode, geen terugval naar de trage Python-interpreter als
compilatie faalt. Dit is dezelfde afkorting als @njit, elders in het package gebruikt. Één
addertje: Numba kan SciPy's comb niet aanroepen, omdat het alleen een beperkte subset van Python en
NumPy compileert. Daarom wordt de binomiaalcoëfficiënt zelf opgebouwd uit faculteiten.
@jit(nopython=True)
def bernstein_basis(u: typing.Any, n_basis: int, k: int) -> float:
    def factorial(n):
        p = 1
        for i in range(1, n + 1):
            p *= i
        return p

    def comb(n, v):
        return factorial(n) / (factorial(v) * factorial(n - v))

    degree = n_basis - 1
    v = k - 1
    return comb(n_basis - 1, k - 1) * (u ** v) * (1 - u) ** (degree - v)
delta, de niveau-operator, gebruikt dezelfde basisfunctie om \(\delta(u) = \sum_{k=1}^M c_k
\varphi_k^M(u)\) op te bouwen, een enkelvoudige sommatie in plaats van een dubbele. Hij accumuleert zijn \(M\)
termen in een init-array die door de aanroeper wordt meegegeven, in plaats van zelf een nieuwe array te
alloceren. Numba's nopython-modus is streng over array-vormen, en deze truc laat dezelfde gecompileerde
functie zowel een scalaire evaluatie als een gevectoriseerde evaluatie over het hele intraday-raster afhandelen.
@njit
def delta(coefs: np.ndarray, u: float, n_basis: int, init: float = 0.0) -> float:
    """Level operator delta(u) = sum_{k=1}^M c_k * phi_k^M(u)."""
    acc = init
    for k, c in enumerate(coefs):
        acc = acc + c * bernstein_basis(u, n_basis, k + 1)
    return acc
Stap 2. De kernel-operatoren opbouwen
kernel_operator bouwt de dichte \(N\times N\) kernel-matrix op als een som van \(M^2\) rank-1-
buitenproducten van Bernstein-kolomvectoren, de dubbele sommatie achter \(\alpha_i,\beta_j\) in de theorie hierboven, nu
uitgeschreven op een raster. Hij is ook JIT-gecompileerd, om dezelfde reden als bernstein_basis: een geneste
Python-loop over \(k,j \in \{1,\dots,M\}\), die Numba omzet in een strakke gecompileerde loop in plaats van
interpreter-overhead \(M^2\) keer per aanroep te betalen.
@jit(nopython=True)
def kernel_operator(
    u: np.ndarray,
    coefs: np.ndarray,
    n_basis: int,
    init: np.ndarray,
) -> np.ndarray:
    acc = init
    col = u.reshape((len(u), 1))
    idx = 0
    for k in range(1, n_basis + 1):
        bk = bernstein_basis(col, n_basis, k)
        for j in range(1, n_basis + 1):
            acc = acc + coefs[idx] * bk @ bernstein_basis(col, n_basis, j).T
            idx += 1
    return acc
_build_operators koppelt de basisfuncties aan een specifieke parameterschatting. Hij snijdt een platte
parametervector op in de delta-, alpha- en beta-coëfficiëntenblokken, en roept vervolgens de gecompileerde
basisfuncties precies één keer aan om delta_hat, alpha_hat en beta_hat op te bouwen als gewone
grid-space arrays. Dit is de grens tussen de JIT-gecompileerde code hierboven en de gewone NumPy-dagloop
hieronder. Elke dag in die loop hergebruikt diezelfde drie arrays in plaats van opnieuw de basisfuncties aan te raken.
Een \(N\times N\) kernel-matrix opnieuw opbouwen kost \(O(N^2 M^2)\). Die kosten één keer per optimizer-stap betalen,
in plaats van één keer per dag, over honderden handelsdagen, is de grootste winst in heel de pipeline.
def _build_operators(
    params: np.ndarray,
    n_basis: int,
    n_grid: int,
    delta_fn: typing.Callable,
    kernel_fn: typing.Callable,
) -> tuple[np.ndarray, np.ndarray, np.ndarray, np.ndarray]:
    grid = np.linspace(1 / n_grid, 1 - 1 / n_grid, n_grid)
    delta_coefs = params[:n_basis]
    alpha_coefs = params[n_basis: n_basis + n_basis ** 2]
    beta_coefs  = params[n_basis + n_basis ** 2:]
    delta_hat = delta_fn(delta_coefs, grid, n_basis=n_basis, init=np.zeros(n_grid))
    alpha_hat = kernel_fn(grid, alpha_coefs, n_basis=n_basis, init=np.zeros((n_grid, n_grid))).T
    beta_hat  = kernel_fn(grid, beta_coefs,  n_basis=n_basis, init=np.zeros((n_grid, n_grid))).T
    return grid, delta_hat, alpha_hat, beta_hat
Stap 3. De dagloop draaien
Met delta_hat, alpha_hat en beta_hat vastgezet, wordt de recursie
\(\sigma_t^2 = \delta + \alpha(y_{t-1}^2) + \beta(\sigma_{t-1}^2)\) een eenvoudige loop over handelsdagen.
Elke integraal wordt een elementgewijs gewogen matrix-vectorproduct, gedeeld door de rastergrootte. Deze loop is
bewust niet JIT-gecompileerd. De kosten per iteratie worden gedomineerd door \(N\times N\)
matrix-vectorproducten, en NumPy stuurt dat werk al naar BLAS, een handmatig getunede, multi-threaded
lineaire-algebra-bibliotheek die Numba's eigen gecompileerde code niet kan verslaan. Een loop compileren waarvan de echte
kosten in een BLAS-aanroep zitten, zou alleen compilatietijd toevoegen zonder snelheidswinst. Het zou ook verhinderen dat de loop
loss_fn als een gewone Python-functie aanroept, en garch_estimator heeft die flexibiliteit nodig,
omdat delta_fn, kernel_fn en loss_fn allemaal vervangen kunnen worden voor een
andere basis.
for t in range(1, n_days):
    variance = (
        delta_hat
        + ((alpha_hat * returns[:, t - 1] ** 2) @ np.ones(n_grid_obs)
        +  (beta_hat  * variance)               @ np.ones(n_grid_obs)) / n_grid_obs
    )
    total_loss += loss_fn(returns[:, t], variance, n_basis, grid)
Stap 4. De fit van elke dag scoren
loss_func berekent een Bernstein-geprojecteerde gemiddelde kwadratische fout tussen de gekwadrateerde rendementen en
de gefitte variantie, gesommeerd over de \(M\) basisfuncties,
\(L_t = \sum_{k=1}^M \frac1N\sum_i \bigl[(y_t^2(u_i)-\sigma_t^2(u_i))\varphi_k^M(u_i)\bigr]^2\). Het is een
goedkopere vervanger voor het formele QMLE-criterium uit de theoriesectie, waarbij wat statistische efficiëntie wordt
ingewisseld voor iets dat snel te evalueren en gemakkelijk numeriek te differentiëren is. Ook deze is JIT-gecompileerd. Hij loopt
over de \(M\) basisfuncties op elke dag, dus hij draait \(M\) keer per dag, keer honderden dagen,
keer duizenden optimizer-evaluaties. Dat is waar de interpreter-overhead het snelst zou oplopen als deze niet
gecompileerd zou zijn.
@jit(nopython=True)
def loss_func(
    returns: np.ndarray,
    variance: np.ndarray,
    n_basis: int,
    grid: np.ndarray,
) -> float:
    total = 0.0
    for k in range(1, n_basis + 1):
        w = bernstein_basis(grid, n_basis, k)
        total += np.mean(((returns ** 2 - variance) * w) ** 2)
    return total
Stap 5. Het model fitten
garch_estimator wrapt de dagloop hierboven en geeft één scalaire loss terug, precies wat
scipy.optimize.minimize nodig heeft. garch_filter draait dezelfde recursie
maar geeft in plaats daarvan het volledige (n_grid, n_days)-variantie-oppervlak terug, en wordt gebruikt zodra het fitten
klaar is, om het gefitte volatiliteitsoppervlak voor de hele steekproef terug te vinden. fit zit boven beide: een
dunne wrapper rond scipy.optimize.minimize die de data en hyperparameters afsluit, zodat
de optimizer alleen maar een functie van de parametervector ziet.
def fit(
    returns: np.ndarray,
    initial_variance: np.ndarray,
    n_grid: int,
    n_basis: int = 1,
    estimator_fn: typing.Callable = garch_estimator,
    delta_fn: typing.Callable = delta,
    kernel_fn: typing.Callable = kernel_operator,
    loss_fn: typing.Callable = loss_func,
    print_convergence: bool = False,
    options: dict | None = None,
    **kwargs,
) -> ResultContainer:
    def _objective(params: np.ndarray) -> float:
        return estimator_fn(
            returns, n_grid, params,
            n_basis=n_basis, initial_variance=initial_variance,
            delta_fn=delta_fn, kernel_fn=kernel_fn, loss_fn=loss_fn,
            print_convergence=print_convergence,
        )

    opt = minimize(_objective, options={'disp': True, **(options or {})}, **kwargs)
    return ResultContainer(**{k: opt[k] for k in opt.__dir__()})
Niet-negatieve Bernstein-coëfficiënten garanderen direct een positief volatiliteitsoppervlak, zonder constrained optimization over de volledige operator. ResultContainer is een kleine key-value-wrapper die elk veld van de onderliggende scipy.optimize.OptimizeResult als attribuut beschikbaar maakt, zodat result.x, result.fun en result.success allemaal werken zoals je zou verwachten.
Samen genomen vraagt het fitten van het model en het terugvinden van het oppervlak twee aanroepen. x0 en
bounds zijn opgebouwd als
[delta_coefs (n_basis) | alpha_coefs (n_basis²) | beta_coefs (n_basis²)], overeenkomstig
de opdeling binnen _build_operators hierboven.
n_basis = 4
n_params = n_basis + 2 * n_basis ** 2

result = fit(
    returns, initial_variance=np.ones(n_grid), n_grid=n_grid, n_basis=n_basis,
    x0=np.zeros(n_params),
    bounds=[(-0.99, 0.99)] * n_params,
    method='SLSQP',
)
sigma2_hat = garch_filter(
    returns, n_grid=n_grid, params=result.x, n_basis=n_basis,
    initial_variance=np.ones(n_grid),
)
Resultaten & empirische discussie
Stappen 1 tot 5 draaien op gesimuleerde intraday-data, gegenereerd uit een bekende functionele GARCH(1,1)-recursie via
funcgarch.simulate.simulate (die dezelfde Bernstein-operator-builders hergebruikt als de schatter
zelf), geeft het gefitte volatiliteitsoppervlak hieronder, met M = 3 basisfuncties.
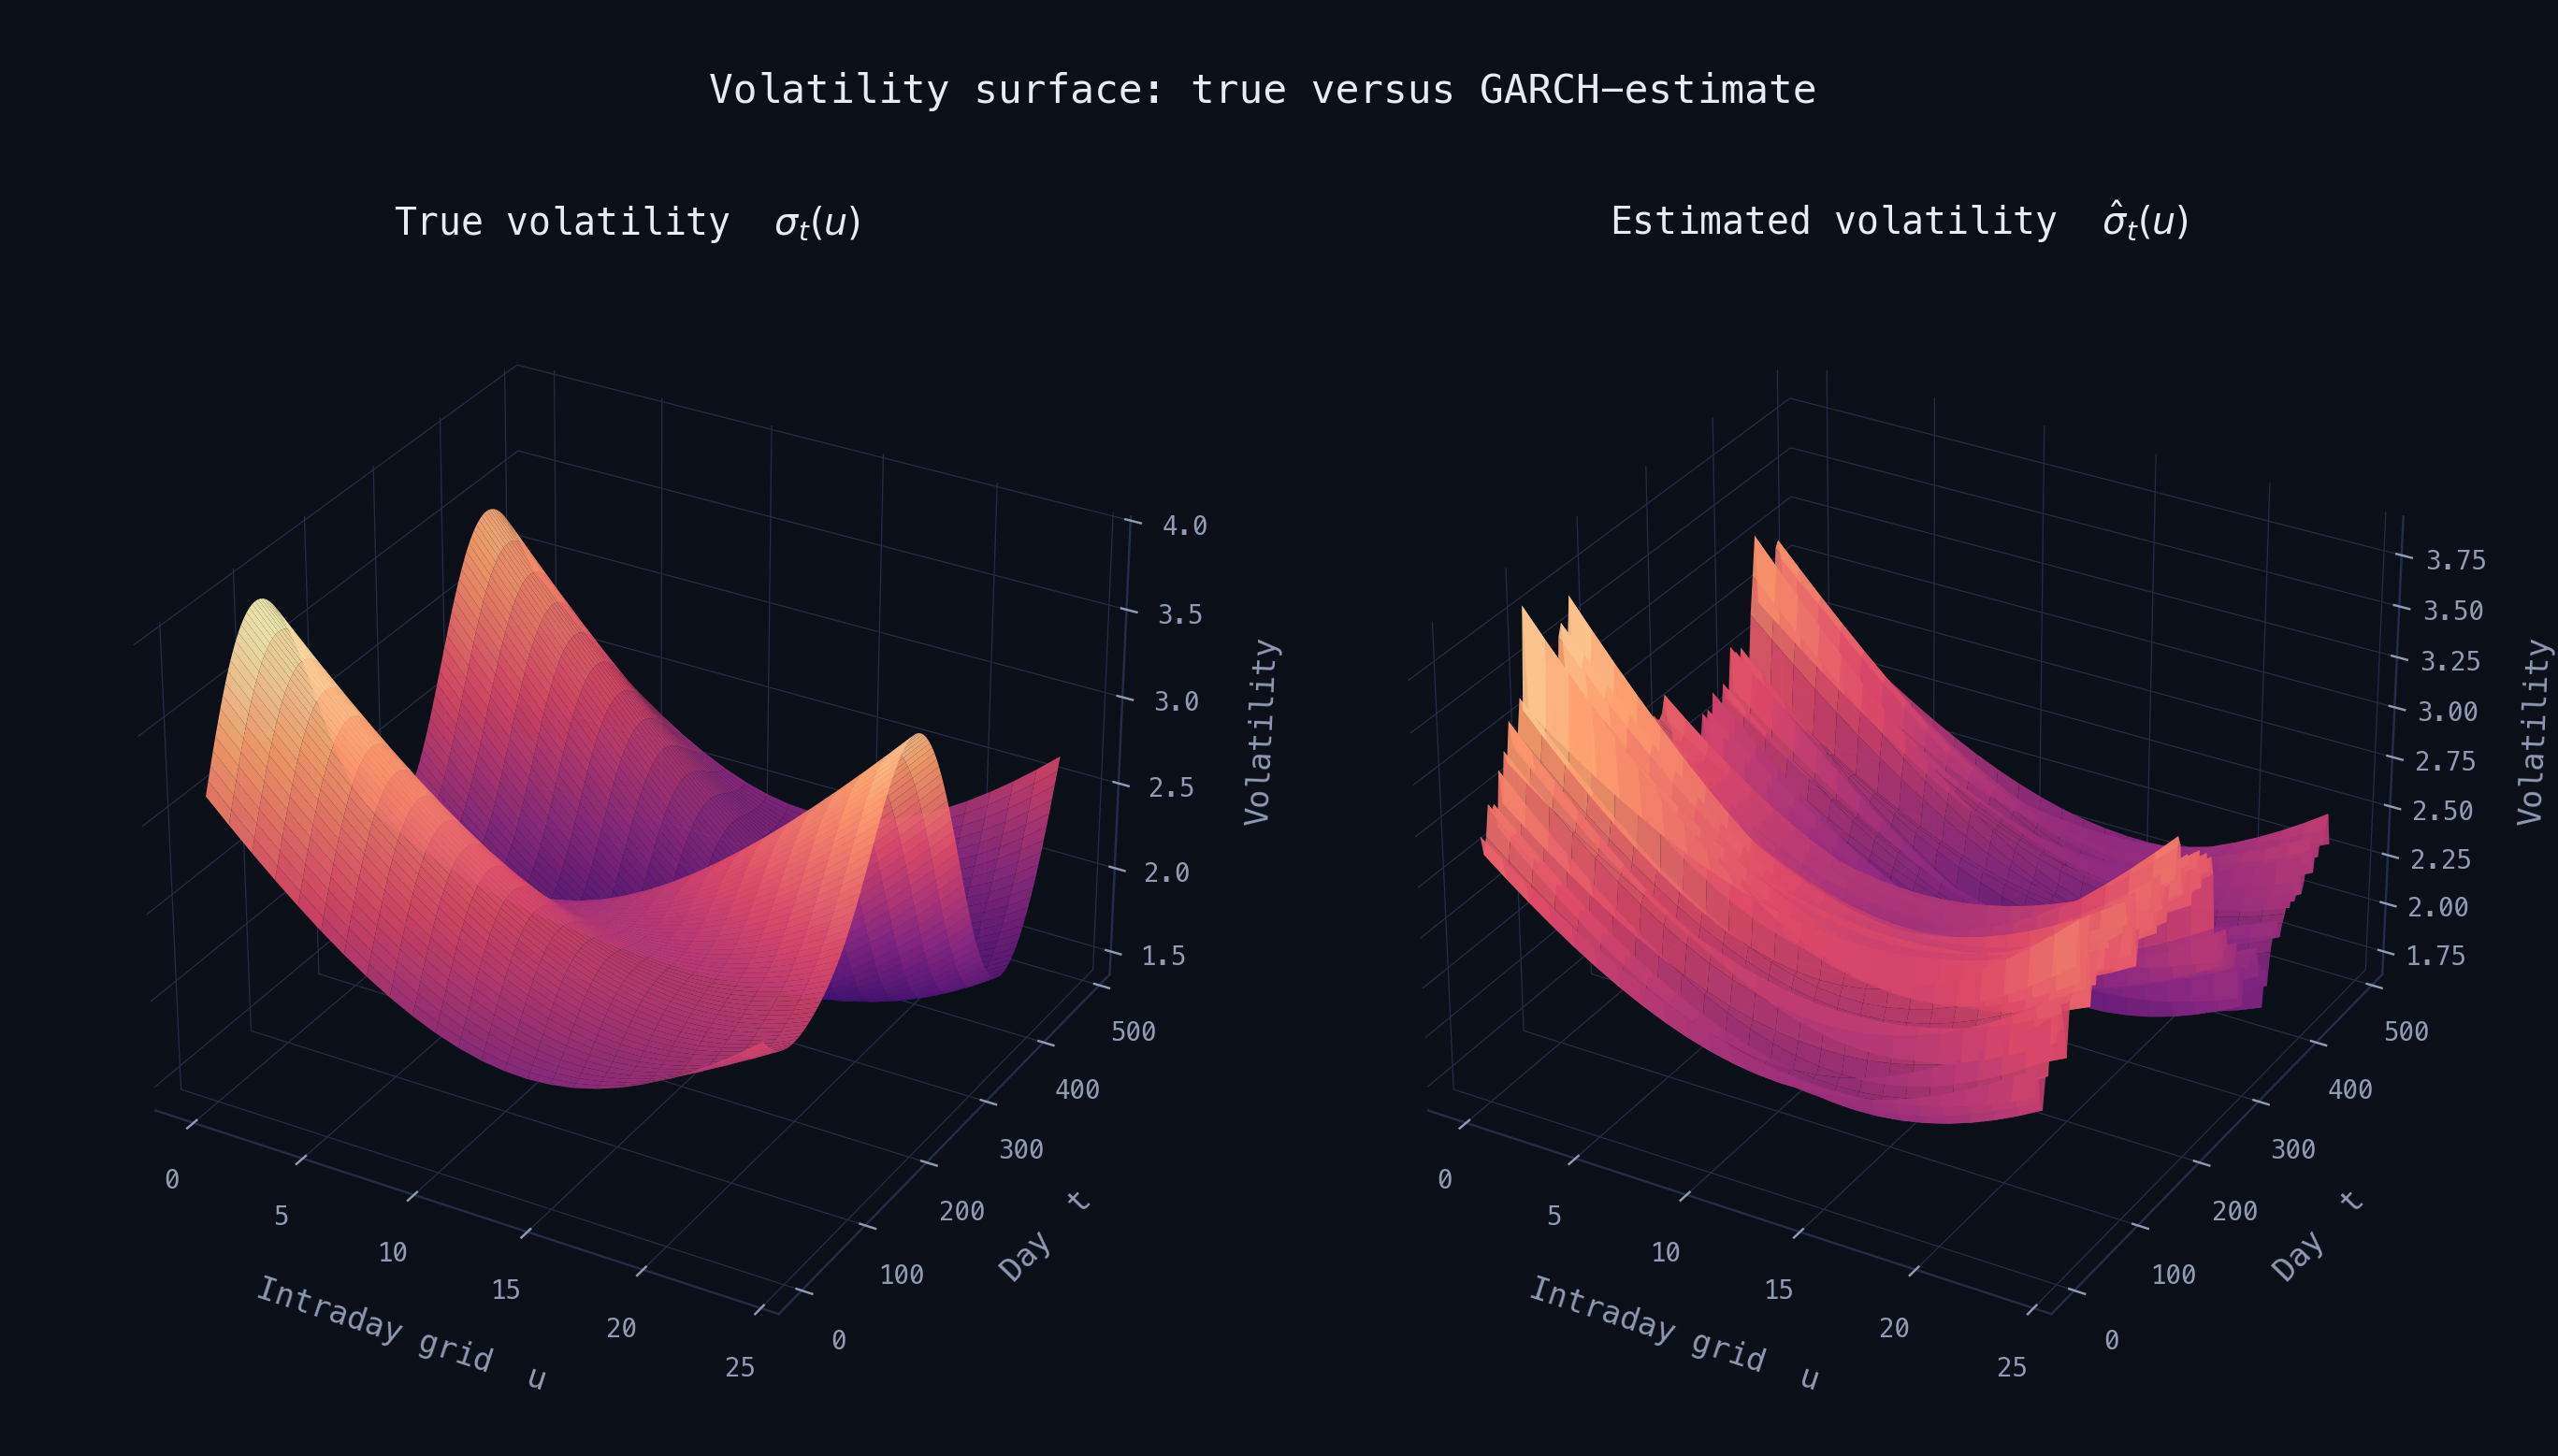
Gesimuleerd 25-punts intraday-raster over 500 handelsdagen. Geschat oppervlak via funcgarch.garch.fit + garch_filter.
De schatting herstelt de hoofdstructuur van het werkelijke proces. De resterende dag-op-dag ruwheid komt van eindige-steekproefeffecten en de beperkte flexibiliteit van een basis met slechts drie functies, niet van een gebrek in de schatter.
Dit weerspiegelt het theoretische beeld uit de eigen simulatiestudie van het onderliggende paper. Op een functionele GARCH(1,1) met een laagdimensionale werkelijke kernel die door de fitting-basis wordt opgespannen, verlaagt de QMLE zowel standaard- deviatie als bias met ruwweg een factor 2–3, relatief ten opzichte van de kleinste-kwadratenschatter van Aue, Horváth & Pellatt (2016). Hij blijft dicht bij zijn doel, zelfs wanneer de instrumentele functies gekozen worden door een datagedreven functional-PCA-achtige routine, in plaats van vooraf vastgelegd. Dat is empirische bevestiging dat de consistentie- en asymptotische-normaliteitsgaranties hierboven ook gelden bij realistische steekproefgroottes, niet alleen asymptotisch.
In de real-data-toepassing op de S&P100-index volgen de gefitte volatiliteitskrommen zowel de gevoeligheid van volatiliteit voor schokken op intraday-schaal als de dag-op-dag-persistentie ervan. De bijbehorende one-day-ahead realised-volatility-voorspellingen, verkregen door de voorspelde variantiekromme te sommeren over het intraday-raster, volgen de werkelijke realised volatility nauwkeurig over steekproefperiodes met wisselende turbulentie. Dat is de praktische opbrengst van een schatter die snel genoeg is om deze recursie echt te draaien op tien jaar minutendata.